4 个月 30,562★、今天冲上趋势第一:阿里把"只做审查"这件事做成了一个 CLI
2026 年 9 月 16 日打开 GitHub 趋势页,排在最前面的是 alibaba/open-code-review,单日 +3,215★;同一天它刚发完 v1.12.4。仓库 2026-05-18 创建,首版 v1.0.0 在 5 月 21 日发布——到今天整 121 天,攒下 30,562★、2,177 fork、168 位贡献者、703 次提交、128 个 release,平均每天涨 253 颗星、每周发 7.4 个版本。npm 包 @alibaba-group/open-code-review 上周(9 月 5-11 日)被下载 93,428 次,近一个月 329,386 次。
但真正让我愿意用一篇的篇幅写它的,不是这个速度,而是它的定位:
它不是"更聪明的编码助手",它只干一件事——审代码。而且它明说了:凡是"不能出错"的环节,绝不让语言模型去猜。
这句话听起来像 slogan,但在这个仓库里是有硬实现的:文件筛选、规则匹配、行号定位全被固化成代码逻辑,模型只负责语义判断。下面把它拆开,拆到你能判断自己该不该用为止。
一句话定位:只做审查的"骨架",不是又一个编码 Agent
- 它是什么:一个 AI 驱动的代码审查 CLI(命令名
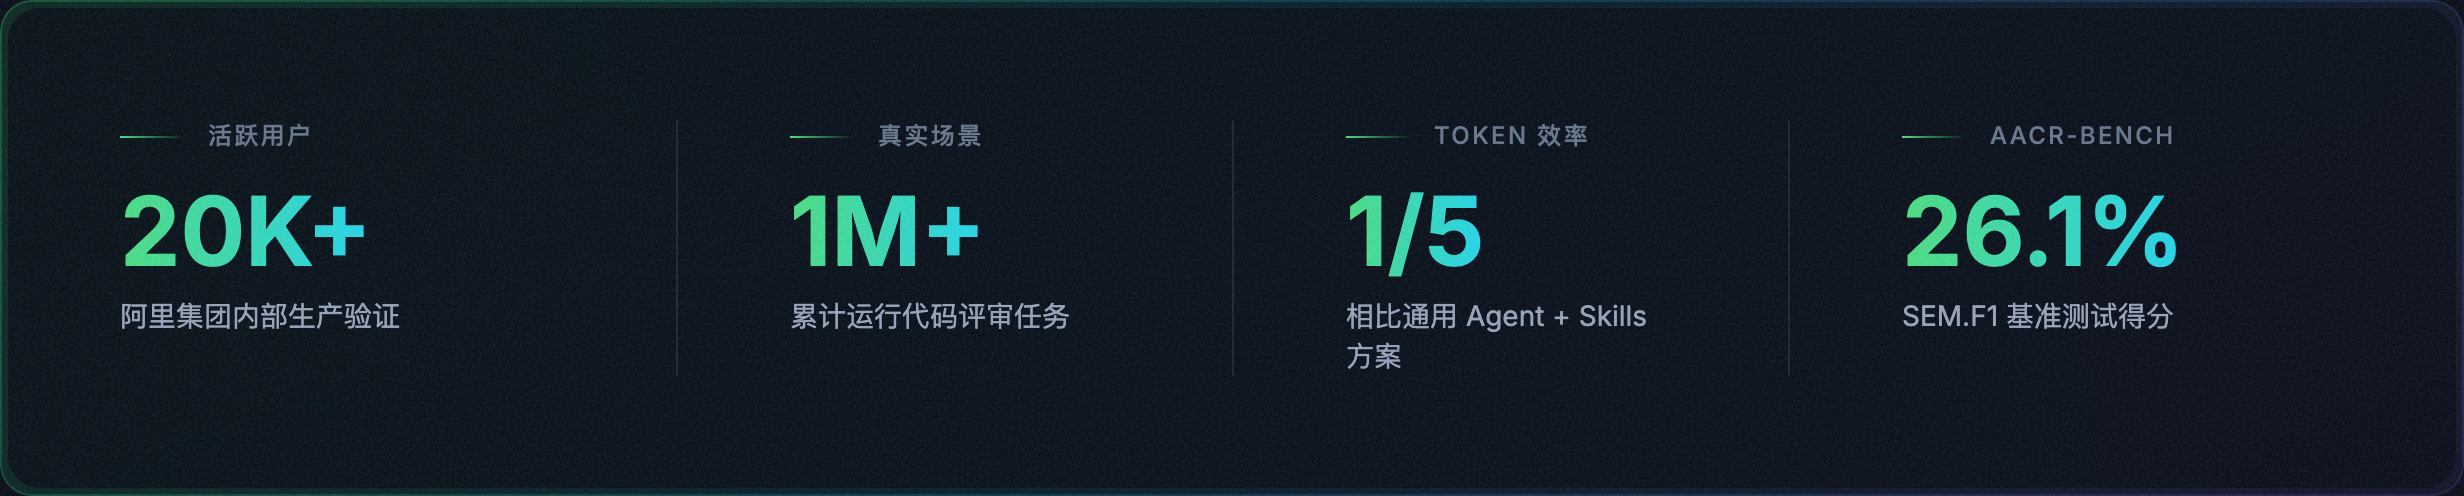
ocr),Go 写的单二进制,Apache-2.0。Git 仓库里跑ocr review,读 diff、按文件匹配规则、调你配的模型,产出带行级的结构化审查意见。 - 它的前身是阿里集团内部的官方 AI 代码审查助手,官方说法是在内部服务了数万名开发者、识别了数百万个代码缺陷,两年后孵化为开源项目,这是项目 README的自述,网易科技当年也做过报道(原链接已失效)。
- 它不碰写代码:仓库 ROADMAP.md 的"明确不做"清单里写得很直白——不做无人值守的自动修复(改代码必须人批)、不做通用编码助手(生成/重构/聊天式写码都不在计划内)、也不自带模型(不自托管 LLM)。
- 它也不是审查平台:不是 Gerrit/GitLab/GitHub 那层评审系统,而是一条插在你现有评审流程里的审查管线,可以和任何平台配合。
- 成本模型是 BYOK(Bring Your Own Key):不订阅、不按席位收费,你自己配模型端点、自己付 token 钱。这是它和托管型商业评审服务最大的分野。
它说自己要治的三个老毛病——哪些是实情,哪些得打折
README 一上来先点名"通用 Agent + Skills 做代码审查"的三个痛点,这段是全文最有争议也最有价值的部分:
- 覆盖不全——改动一大,Agent 会"抄近路",挑几个文件看,其余略过。一次提交改 30 个文件,报告里只出现 5 个。
- 位置漂移——报出来的问题对不上真实位置,行号偏了、文件引用错了。
- 质量不稳——自然语言驱动的 Skills 难调试,提示词微调一下,结果就剧烈波动。
我的判断:第 1、2 条是真痛点,而且是结构性的——通用 Agent 的上下文是连续的,文件一多必然要"取舍",这不是提示词能修好的;第 3 条一半对一半不对:稳定性的问题真实存在,但"提示词换字就波动"这个描述是把对比对象写成了最差情形,读者自己心里有数就行。
它给的数据是自评基准:50 个热门开源仓库、200 个真实 PR、10 种语言、80+ 位资深工程师交叉标注出 1,505 个真实缺陷(数据集在 Hugging Face: Alibaba-Aone/aacr-bench)。结论是同一底层模型下,Precision 与 F1 显著高于通用 Agent(Claude Code),token 只花约 1/9,速度更快,但召回率(Recall)更低——官方自己承认这是"宁可漏报不误报"的有意取舍。
这一段必须分清楚:声明是"更高准确率 + 1/9 token",实锤是"召回率更低"。对 CI 门禁这种"误报会让人烦到把工具关掉"的场景,precision-first 是对的;对安全审计这种"漏一个就出事"的场景,它自己承认不够,要等 ROADMAP 里的 Ultra Mode(高召回模式)。
核心设计:把"不能出错"的环节从模型手里拿走
它的架构词叫 Deterministic Engineering × Agent Hybrid,分工非常清楚:
确定性工程侧(不交给模型的四件事)
- 精准文件筛选:哪些文件进审查、哪些被过滤,由代码决定,保证重要改动不漏。
- 智能文件打包:把关联文件归并成同一个审查单元——README 举的例子很典型:
message_en.properties和message_zh.properties会被打包在一起(这两个文件必须一起看,否则改一个漏一个)。每个包是一个独立上下文的 sub-agent,自带并发,大变更集上比"一口气塞给一个 Agent"稳得多。 - 精细化规则匹配:用模板引擎按文件特征派发规则,不靠提示词"讲故事"。
- 外挂的定位与反思组件:独立的评论定位模块 + 评论反思模块,专门治"行号漂移"和"评论前后矛盾"。
Agent 侧(交给模型的两件事)
- 场景化提示词:为代码审查深度调优过的模板,目标之一是省 token。
- 专属工具集:据官方描述,工具集是从生产环境真实调用轨迹(调用频率分布、单工具重复率、新工具对调用链的影响)里蒸馏出来的——不是把通用 Agent 的工具箱直接搬过来。
文件进入审查前,要过六道门(这是全文最硬的工程细节)
过滤逻辑在 internal/agent/selection.go,顺序固定,逐门淘汰:
| 顺序 | 门 | 判据 | 能否被绕开 |
|---|---|---|---|
| 1 | binary | 二进制文件 | 否 |
| 2 | secret_exclude | 命中内置敏感路径保护(共 10 条模式,如 .env.*) | 否——优先级高于用户规则,include 也盖不住 |
| 3 | user_exclude | 你自己的 exclude glob | 用户配置里优先级最高 |
| 4 | user_include | 命中你的 include 就立即保留 | 会绕过下面两道门 |
| 5 | unsupported_ext | 扩展名不在白名单(111 个扩展名)内 | 用 include 可绕 |
| 6 | default_path | 命中内置测试文件排除模式(55 条,*_test.go、*.spec.ts 等) | 用 include 可绕 |
第六道门之外还有一条:单个文件的 diff 本身超过 prompt 上限的 80%,会被标记 too_large 跳过(review 默认上限 200,000 token,即约 160k)。另外 vendor/、node_modules/ 这类依赖目录在更早的 diff 层就被折叠掉了,永远不评审。
这套设计最实用的地方是:你可以零成本先看它到底会审什么——
| |
输出会逐行给出每个文件被保留或丢弃的原因(excluded: user_exclude、excluded: unsupported_ext……),排障时不用猜。
全文最厚的一节:它到底有哪些功能
1. 两种审查模式 + 三种 diff 范围 + 断点续跑
| 模式 | 命令 | 输入 | 适合什么 |
|---|---|---|---|
| diff 审查 | ocr review | Git diff | 日常提交、PR 审查、CI 流水线 |
| 全文件扫描 | ocr scan | 完整文件(不依赖 diff) | 审计陌生代码库、接手别人的项目、迁移前体检 |
ocr review 又分三种范围:工作区模式(暂存 + 未暂存 + 未跟踪,默认)、分支区间(--from main --to feature,按 merge-base 计算)、单提交(--commit abc123)。区间和单提交模式支持 --resume <session-id> 断点续跑——大 PR 跑到一半断了不用从头再来,ocr session list 可以列出历史会话。
注意一个边界:ocr scan 按文件枚举自己走,所以非 Git 目录也能扫;但 ocr review 依赖 git 命令,官方 FAQ 明确说不支持 SVN / Mercurial。
2. 规则系统:45 份语言规则、4 层优先级链
规则是这套东西的灵魂。它对每个文件路径按 4 层优先级解析,第一个匹配上的生效:
| 优先级 | 来源 | 路径 | 用途 |
|---|---|---|---|
| 1(最高) | --rule 参数 | 你在命令行指定 | 单个 PR 换一套审查清单,如"这次只做安全评审" |
| 2 | 项目配置 | <仓库>/.opencodereview/rule.json | 项目规范,可以安全提交进仓库 |
| 3 | 全局配置 | ~/.opencodereview/rule.json | 你个人的偏好,本机所有仓库继承 |
| 4(最低) | 系统内置 | 编译进二进制的 system_rules.json | 兜底,永远存在 |
内置的规则文档一共 45 条,按文件类型派发:Java、Go、Python、TypeScript/JS、Rust、Kotlin、C/C++、PHP、R、Julia、Elm、Swift 之外,还包括一批"通用 Agent 根本不会专门给你写的"文件——MyBatis 风格 mapper XML(防 SQL 注入)、pom.xml / build.gradle / package.json / Cargo.toml / composer.json(依赖与构建配置)、GitHub Actions 工作流 YAML、FreeMarker 与 Handlebars 模板(SSTI/XSS)、Terraform / Bicep 云资源、Protobuf / Thrift / Cap’n Proto 的线协议兼容性、Solidity / Vyper 合约、Verilog / VHDL 硬件描述、Prisma / GraphQL schema。README 的 description 里点名的那几类内置检查是:NPE、线程安全、XSS、SQL 注入。
自定义规则长这样(项目级,可提交):
| |
glob 用的是 bmatcuk/doublestar/v4(< 跨目录、{a,b} 花括号、字符类),匹配不区分大小写。规则按声明顺序求值,首条匹配生效——所以越具体的规则要越往前放,这个坑官方 FAQ 里专门列了({ts, tsx} 中间多一个空格就静默失配)。
3. 模型自由度:23 家内置供应商、4 种协议
这是对国内读者最友好的一点。ocr config provider 内置了 23 家供应商,预置好 Base URL 与协议,你只填 key:
- 国际:Anthropic、OpenAI(含
openai-responses协议)、Google Gemini、xAI、AWS Bedrock(走 SigV4 签名,不需要 key)、Novita - 国内:阿里云百炼 DashScope(含 Token Plan 专属端点)、火山引擎 Ark、DeepSeek、腾讯 TokenHub / 混元 Token Plan、讯飞星火、Kimi(国内 + 国际两套)、智谱 z-ai(open.bigmodel.cn)、小米 MiMo、MiniMax(国际 + 国内)、百度千帆、硅基流动(国际 + 国内)
协议只有 4 种:anthropic、anthropic-bedrock、openai、openai-responses。想用自建网关(LiteLLM、公司内网模型服务、Ollama 本地模型)就在 custom_providers 里填 URL + key + model——这不影响任何其他功能。key 不落盘也行:api_key_cmd 支持运行时从 1Password、pass、macOS Keychain 取 key。
一个必须提前知道的硬门槛:模型必须支持原生工具调用(function calling)。官方 FAQ 里给了实证——只在文本(或 <think> 块)里"叙述"工具调用的模型,不管怎么改提示词都跑不起来,deepseek-r1 是常见例子;而 qwen3 这类原生支持的正常。本地 Ollama 用户请从带 tools 标签的模型里挑。
4. 集成面:从 Claude Code 到 CI,一共多少条路
| 接法 | 怎么装 | 谁调模型 |
|---|---|---|
| Claude Code 插件 | /plugin marketplace add alibaba/open-code-review 再 /plugin install | OCR(或委托模式) |
| Codex 插件 | codex plugin marketplace add alibaba/open-code-review | OCR(或委托模式) |
| Cursor 插件 | 把 plugins/open-code-review/ 拷到 ~/.cursor/plugins/local/ | OCR(或委托模式) |
| OpenCode | 安装原生评审工具 + 斜杠命令 | OCR |
| 任意兼容 Skill 的 Agent | npx skills add alibaba/open-code-review --skill open-code-review-delegate | 宿主 Agent |
| 委托模式 | 仅装 ocr CLI | 宿主 Agent,用你自己的订阅额度 |
| CI/CD | GitHub Actions(官方工作流)、GitLab CI、Gerrit、Bitbucket Pipelines、阿里云 Codeup、GitFlic | CI 里配的模型 |
| MCP | 官方 MCP server,把评审能力暴露给任意 MCP 客户端 | OCR |
| VSCode | 仓库里有 extensions/vscode 插件源码 | OCR |
委托模式值得单独说:ocr 只做确定性那半场(选文件、解析规则、收集 diff),把"审查"这活交给宿主 Agent,用宿主自己的订阅额度跑,OCR 端不需要任何 API key。对已经付了 Claude Code / Codex 月费的人,这是零边际成本的路子:
| |
GitHub Actions 那条路给了可直接复制的工作流示例:PR 打开(或 synchronize/reopen)自动审,同时支持在 PR 里评论 /open-code-review 按需重跑;每条发现通过 GitHub Pull Request Review API 贴成内联评论,没有行信息的合并进摘要;还能把结果以 SARIF 格式上传到 GitHub Code Scanning。需要的 secret 是 4 个:OCR_LLM_URL、OCR_LLM_AUTH_TOKEN、OCR_LLM_MODEL、OCR_LLM_USE_ANTHROPIC(后两个可以走 variables)。
它用 pull_request_target 而不是 pull_request,理由是fork 提交的 PR 也能拿到 secret,而 OCR 只读 diff、不执行 PR 里的代码——这个取舍在官方的示例文件注释里写明了,属于知情的工程选择。
5. 输出与可观测:JSON / SARIF + 浏览器回放 + token 计量
- 输出格式三选一:
text(人看)、json(机器读,ocr review --format json永远向 stdout 写恰好一个 JSON 对象)、sarif(给 GitHub Code Scanning)。 --audience agent会彻底去掉进度行,让 stdout 只剩 JSON——这是给上游 Agent 和 CI 脚本准备的;人类模式下的进度行走 stderr,所以ocr review --format json > result.json在终端里照样能看到进度。ocr viewer起一个本地 WebUI,可以回放每一次评审会话,把评论标记成已修复/已忽略并在处理时隐藏。会话原文是 JSONL,存在~/.opencodereview/sessions/<编码后的仓库路径>/下。- 遥测是 OpenTelemetry,关注
ocr.llm.tokens_used、ocr.llm.requests_total、ocr.llm.request_duration_seconds三个指标——这是你查"钱花在哪"的官方手段。
6. 参数与默认值(成本旋钮都在这张表里)
| 参数 | 默认 | 说明 |
|---|---|---|
--concurrency | 8 | 并行 sub-agent 数。被限流就调低到 4 |
--timeout | 15 分钟 | 每个 sub-agent 的截止时间,按 effort 线性放大(low/medium/high 分别 15/30/45) |
--effort | medium | low = 1 轮主循环,medium = 2 轮,high = 3 轮。轮数越多召回越高、token 越贵 |
--max-tokens | review 200000 / scan 58888 | 只限制 prompt。输出上限另有 MAX_COMPLETION_TOKENS = 16384,调它不会放大输出 |
--max-tokens-budget | 0(不限) | 本次评审输入 + 输出的总预算,超了就停止派发,已产生的部分结果仍会发布 |
--max-tools | 100 | 单文件工具调用轮数上限,只能上调(1-49 会被拉到 50) |
--no-filter | false | 跳过评审后的 LLM 后处理,减少一次调用 |
一个反直觉但很有用的细节:文件 ≥50 行(或多文件合计 ≥100 行)时会触发 plan 阶段,每组多一次 LLM 调用。所以调高这两个阈值才省钱,调低反而更贵。
怎么用起来:最快一条路
| |
国内网络的小工具:GitHub release 下载慢的话,可以设 OCR_GITHUB_MIRROR(裸域名,如 gh-proxy.com,作为路径前缀)走镜像;但要注意官方文档自己标了安全提示——镜像模式下的二进制和校验和来自同一个第三方,完整性保证失效。要完全跳过 GitHub API 的版本解析,就把 OCR_VERSION 固定成具体 tag。另外 npm wrapper 默认自动更新(18 分钟冷却一次),CI 里不想版本漂移就 export OCR_NO_UPDATE=1 或锁版本装。
它在你机器上留下什么:只有一个目录 ~/.opencodereview/(配置、全局规则、会话 JSONL)。不写这个目录之外的任何地方,卸载就是 npm uninstall -g + rm -rf ~/.opencodereview。这点对洁癖玩家很友好。
一次审查到底花多少钱(用今天的官方价目表算)
它没有订阅费,所以只有一个变量:你配的模型 × 用掉多少 token。拿国内最好算账的 DeepSeek 举例,我用的是它的官方价目页(api-docs.deepseek.com,2026-09-16 取数),deepseek-flash 的价是(单位:美元 / 100 万 token):
| 项目 | 闲时 | 峰时 |
|---|---|---|
| 输入(缓存命中) | $0.003 | $0.006 |
| 输入(缓存未命中) | $0.15 | $0.30 |
| 输出 | $0.60 | $1.20 |
峰时是 UTC 周一至周五 01:00-04:00 和 06:00-10:00,其余时间按闲时(半价)。
按 OCR 自己的 token 上限推三个场景(输入量是假设值,价格是官方实时价):
| 场景 | 假设 token 用量 | 闲时成本 | 峰时成本 |
|---|---|---|---|
| 小改动(3-5 文件、不到 50 行,不触发 plan) | 3 万输入 + 3000 输出 | 约 $0.006 | 约 $0.013 |
| 中等 PR(30 文件、约 600 行,8 并发 + plan) | 40 万输入(一半命中缓存)+ 6 万输出 | 约 $0.067 | 约 $0.133 |
| 大 PR(1.2M 输入、15 万输出,60% 命中缓存) | 120 万输入 + 15 万输出 | 约 $0.164 | 约 $0.328 |
也就是说,日常小改动一次评审的成本在不到一美分这个量级,一天评几十次也就几毛钱。同样的中等 PR 换成 deepseek-v4-pro 约 $0.26。
再叠上它自己的 benchmark 声明(同模型下 token 约为通用 Agent 的 1/9),以及成本旋钮(--effort low 把主循环从 2 轮降到 1 轮约省一半、include 白名单把无关文件挡在门外、--max-tokens-budget 硬顶预算、--background 一次把业务背景喂进去减少来回检索),这套账对个人开发者和小团队是真能算得平的。
和同类比:它处在哪一档
| 方案 | 谁调模型 | 成本 | 规则/定制 | 适合谁 |
|---|---|---|---|---|
通用 Agent 自带评审(Claude Code 的 /review、各家 IDE Agent) | 宿主 Agent | 已含在订阅里 | 自然语言 Skills,难调试、难复现 | 顺手看两眼、改动小 |
| 本项目 · 默认模式 | OCR 调你配的模型 | BYOK 按 token | 4 层规则链 + 45 份内置语言规则 + 111 种文件类型 | 想要覆盖稳定、结果可复现、要进 CI 的人 |
| 本项目 · 委托模式 | 宿主 Agent(自己的订阅) | 零额外成本 | 同上(规则/筛选仍由 OCR 提供) | 已经付了 Claude Code/Codex 订阅的人 |
| 托管型商业评审服务 | 厂商托管 | 按席位/仓库订阅,代码要过厂商 | 厂商定,可配性有限 | 不想自己管 key、愿意为省事付钱 |
| 传统静态规则扫描(SonarQube、ESLint、各语言 linter) | 没有模型 | 自建 | 确定性规则、零误报成本低 | 风格与已知缺陷模式,和 OCR 互补,不是替代 |
它的差异化就一句话:把"审查流程里不能出错的部分"做成可调试、可复现、可提交进仓库的工程配置,而不是一段自然语言提示词。这也是它敢跟通用 Agent 正面比 precision 的底气所在。
反过来说,它的短板同样是结构性的:召回率刻意做低。它把"宁可漏报"写进了设计目标(理由是"一条被忽略的误报评论,等于这次审查没发生"),所以不要拿它当安全审计的唯一一道门——高风险变更集等 ROADMAP 里的 Ultra Mode(用更高 token 和时间换召回)。
我的判断:谁现在就该上、谁再等等、谁别碰
现在就该上
- 一个人在接活/做外包的独立开发者:你最大的痛点是"没人给你审代码"。一个 PR 花几美分拿到行级意见,而且规则能写进
.opencodereview/rule.json提交进仓库,下次开工自动继承——这是个人经验变成资产的最便宜方式。 - 小团队(3-10 人)已经用 Claude Code / Codex:直接走委托模式,一分钱额外成本不花,拿到的是"文件筛选 + 规则匹配 + 位置校准"这套确定性工程。踩中"改动一大 Agent 就偷懒"的人收益最明显。
- 用 GitHub/GitLab 管代码、想让评审自动跑起来的副业者:Actions 工作流复制进去、配 4 个 secret 就能跑,还能把结果打成内联评论。注意 CI 里记得
OCR_NO_UPDATE=1或锁版本。 - 只有 1.6G 小服务器的玩家:可以用——它是客户端,主体是 50-55MB 的静态二进制,评审算力在云端模型上,不占你的内存。只有当你把模型指到本机 Ollama 时才需要大盘子(参考《1.6 GB 服务器能跑什么》的内存清单)。
再等等
- 想拿它做安全审计主力的人:召回率是它公开承认的弱项,官方把高召回的 Ultra Mode 放在 H2 2026 计划里。
- 想用 JetBrains 全家桶(IntelliJ/GoLand/PyCharm)的人:JetBrains 插件和 VSCode 插件一样在 ROADMAP 里列为 H2 2026 计划;仓库里现有的
extensions/vscode也只给了开发构建路径(yarn install+yarn watch),没有现成的市场安装说明——想用得自己 build。 - 跑本地小模型的人:必须是原生支持 function calling 的模型。8B 以下的小模型经常"嘴上说调用工具、实际没调",官方 FAQ 里那套自检命令建议先照着测一遍。
别碰
- 指望它自动改代码的人:ROADMAP 的"明确不做"第一条就是无人值守的自动修复。它出意见,改不改、怎么改,永远由人拍板。
- 要求代码完全不经过第三方模型的人:它的工作方式就是把 diff(以及 read 工具读到的代码片段)发到你配置的模型端点。想不出网,只有自建网关 + 自托管模型这条合规路径;而且扫描前脱敏 secret 不是内置功能(官方说在路线图里),敏感文件要自己写进
exclude,或用 pre-commit 钩子先把 secret 过滤掉。 - 用 SVN / Mercurial 的人:diff 层是靠 shell 调
git实现的,官方明确不支持非 Git 版本控制。 - 把 star 数当社区健康度的人:168 位贡献者里,第一位提交了 273 次,第二位只有 35 次——这是"阿里内部团队 + 零散社区 PR"的形态,不是靠社区自然生长的项目。跟着它走,实质上是跟着一个公司团队的节奏走(好处是 121 天发 128 个版本、当天还在推代码;风险是长期维护取决于阿里的意志)。
几个容易踩的坑(逐条给修法)
- 文件没被审 → 跑
ocr review --preview(不花钱),它会告诉你每个文件被哪道门拦下:user_exclude/unsupported_ext/default_path/too_large/provider_directory。测试文件被拦是预期行为,要审就把它加进include。 Token threshold exceeded→ 单文件 prompt 超过上限 80%,该文件被跳过。把生成的巨型文件加进exclude,或把大重构拆成多个小 commit 用--commit逐个审。Max tool requests reached→ 模型用满 100 轮工具调用还没喊task_done。换更强的模型,或--max-tools 150(只能上调),同时做好每文件成本大致线性上升的准备。no valid LLM endpoint configured→ 它取第一个完整的三元组,不是最后一个:配置文件里三个llm.*都在,环境变量就被忽略。要么删配置 key,要么用ocr config set改。- 401 / 403 → 检查协议和 URL 是否配套:Anthropic 走
/v1/messages+use_anthropic=true,OpenAI 兼容走/v1/chat/completions+use_anthropic=false。 - 评论行号是
start_line: 0→ 模型改写了existing_code没照抄 diff。评论内容是真的,只是没自动锚定;主流 Agent 集成会读existing_code自己定位。中文项目里 CRLF 和 tab/空格混用也会破坏滑动窗口匹配。 - CI 比本地慢很多 → 通常是模型限流(把
--concurrency降到 4)或 prompt 缓存冷启动。
Roadmap:接下来盯什么
- H2 2026:JetBrains 插件、Ultra Mode(高召回模式,用 token 和时间换召回率)、以及"订阅友好"的委托模式。
- H1 2027:领域长期记忆——让审查引擎积累项目特有的约定与历史决策,减少重复意见。
- 明确不做:无人值守自动修复、通用编码助手、自带/托管模型。
有一处对不上,顺便说清:ROADMAP 把"订阅友好、去掉独立 API key 的委托模式"列在"计划中",但官方文档里委托模式已经可用并有完整命令(ocr delegate preview / ocr delegate rule)——路线图这份文件滞后于实际实现,读它的"计划"部分时打个折。
一句话总结
30,562★ 不是靠 README 喊出来的,是因为它精准命中了"AI 写代码越来越快、但没人审得过来"这道裂缝——而且它没有去做第 101 个编码 Agent,而是把审查做成了一个可配置、可复现、能进 CI、能写进仓库的工程件。
对独立开发者和接活的人:一个 PR 几美分,换来一份带行号的审查清单,规则还能沉淀成仓库里的文件。值。
对已经付了 Claude Code / Codex 订阅的人:走委托模式,零额外成本拿到确定性筛选 + 规则匹配。性价比最高的一条路。
对想拿它替掉安全审计或指望它自动修 bug 的人:它的召回率是自己承认的短板,自动修复是官方明确不做的事。别碰。
顺带一提:代码评审工具选完,写代码的手感也值得投资——机械键盘怎么选从 159 到 389 按人群锁款。
本文由拾光札记编辑部整理,勘误请联系我们。
本文数据来自 GitHub REST API、仓库官方文档(中文版 pages/src/content/docs/zh/)、官方 README/ROADMAP 与公开报道的逐项核对,取数时间 2026-09-16 晚间;star/fork 等数字会实时变动,以仓库页为准。
互链提示:同主题前文(本站 AI 与效率 / 服务器实践分类)可对照阅读: